Kısa cevap: cevaplarda görünmek istiyorsanız açık tutun. Engellemek içeriğinizin eğitim verisine girmesini azaltıyor, ama sizi cevaplardan da çıkarıyor. Karar, içeriğinizin size ne kazandırdığına bağlı ve her site için aynı değil.
Bu konuda net bir doğru cevap yok, bu yüzden önce botların ne yaptığını ayırmak gerekiyor. Hepsi aynı işi yapmıyor ve hepsini aynı kefeye koymak yanlış kararlara yol açıyor.
Hangi bot ne için geliyor?
İki ayrı iş var ve bu ayrım kararın merkezinde duruyor. Bazı botlar modeli eğitmek için içerik topluyor; bazıları kullanıcı bir soru sorduğu anda cevabı kurmak için sayfaya geliyor.
| Bot | Kim | Ne için | Engellenirse |
|---|---|---|---|
| GPTBot | OpenAI | Model eğitimi için tarama | İçerik eğitim verisine girmez |
| OAI-SearchBot | OpenAI | Arama ve cevap kurma | Cevaplarda kaynak gösterilmezsiniz |
| ChatGPT-User | OpenAI | Kullanıcı bir adres verdiğinde o sayfayı okuma | Kullanıcı sayfanızı açtıramaz |
| ClaudeBot | Anthropic | Tarama | İçerik alınmaz |
| PerplexityBot | Perplexity | Arama ve cevap kurma | Cevaplarda görünmezsiniz |
| Google-Extended | Google’ın yapay zekâ ürünleri | Arama sıralamanız etkilenmez | |
| Googlebot | Arama dizini | Arama sonuçlarından çıkarsınız |
Tablodaki son iki satır çok önemli ve sık karıştırılıyor. Google-Extended’i engellemek arama sıralamanızı etkilemiyor; sadece Google’ın yapay zekâ ürünlerinde içeriğinizin kullanılmasını sınırlıyor. Googlebot’u engellemek ise sizi arama sonuçlarından çıkarıyor. İkisini karıştırmak ciddi bir hata.
İkinci ve üçüncü satır da ayrı değerlendirilmeli. Eğitim için gelen botu engelleyip cevap kurmak için geleni açık tutmak mümkün. Böylece içeriğiniz eğitim verisine girmiyor ama cevaplarda kaynak olarak gösterilebiliyorsunuz.
Engellerseniz ne olur?
Kazandığınız şey: içeriğiniz model eğitiminde kullanılmıyor. Telif konusunda hassas bir işletmeyseniz ya da içerik satıyorsanız bu önemli bir kazanç.
Kaybettiğiniz şeyler:
- Sohbet araçlarının cevaplarında kaynak olarak gösterilmiyorsunuz
- O cevaplardan gelen yönlendirme trafiğini alamıyorsunuz
- Rakipleriniz o cevaplarda yer alıyor, siz yer almıyorsunuz
- Marka adınız sorulduğunda araç sizin sitenize bakamıyor, başka kaynaklardan bilgi kuruyor
Son madde çoğu zaman atlanıyor ve sonucu can sıkıcı. Kendi sitenizi kapatırsanız, araç sizin hakkında bilgiyi üçüncü taraf kaynaklardan topluyor. O kaynaklardaki bilgi eski ya da yanlışsa düzeltme şansınız kalmıyor.
Açık tutarsanız ne olur?
Kazandığınız şey: cevaplarda görünme ihtimali ve oradan gelen trafik. Bu trafik hacim olarak küçük ama niteliği yüksek oluyor; gelen kişi cevapta sizi gördüğü için geliyor.
Kaybettiğiniz şey: içeriğinizin eğitim verisinde kullanılması ve bunun üzerinde kontrolünüzün olmaması.
Benim müşterilerimde varsayılan tercihim açık tutmak. Sebebi şu: çoğu işletme için içerik, ürünü satmaya hizmet eden bir araç; ürünün kendisi değil. Blog yazısının kopyalanması bir kayıp değil, o yazının müşteri getirmemesi kayıp.
Ama bu her iş için doğru değil. İçeriğin kendisini satan bir yayıncıysanız, abonelikle para kazanıyorsanız ya da özel araştırma yayımlıyorsanız hesap değişiyor.
robots.txt nasıl yazılır?
Kurallar dosyanın kökünde, siteniz.com/robots.txt adresinde durur. Bot adı ve kuralı yazılır.
Hepsini açık tutmak için özel bir şey yapmanız gerekmiyor; dosyada o botla ilgili bir kural yoksa erişim açık demektir.
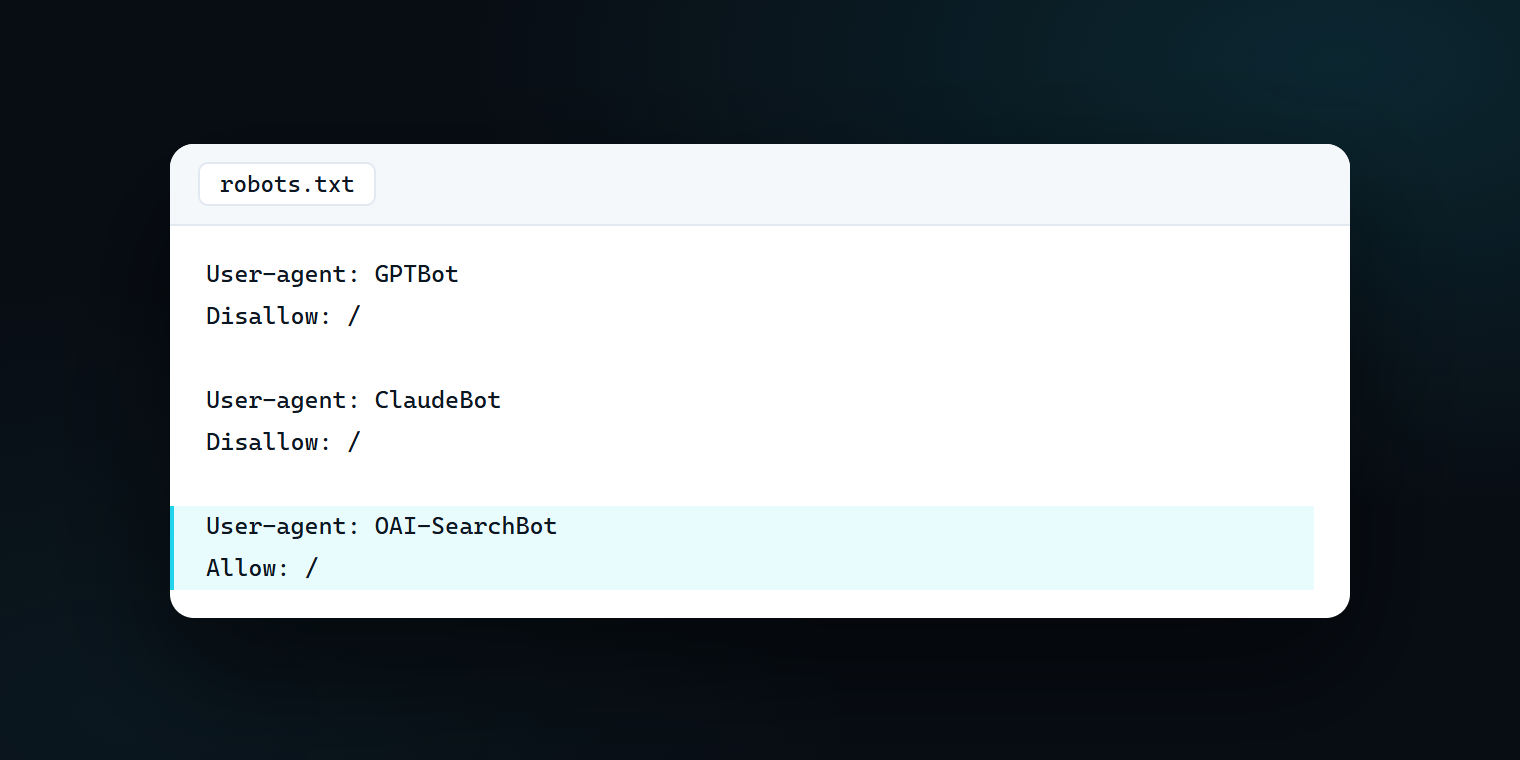
Eğitim taramasını kapatıp cevap kurmayı açık tutmak için:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
Hepsini kapatmak için:
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Disallow: /

User-agent: ChatGPT-User
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: PerplexityBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Bir uyarı: User-agent: * satırının altına yazdığınız kural bütün botlar için geçerli oluyor, Googlebot dahil. Yapay zekâ botlarını kapatmak isterken arama motorunu kapatmak, gördüğüm en pahalı robots.txt hatası.
Bir uyarı daha: robots.txt bir rica, bir engel değil. Kurallara uyan botlar uyuyor, uymayanlar için sunucu tarafında engelleme gerekiyor.
Shopify ve kapalı altyapılarda nasıl yapılır?
Shopify’da robots.txt doğrudan düzenlenmiyor ama robots.txt.liquid adında bir tema şablonu oluşturularak kurallar değiştirilebiliyor. Tema bölümünden Kodu düzenle, sonra yeni şablon.
ikas ve benzeri kapalı altyapılarda panelden dosya düzenlemesi olmayabiliyor. O durumda destek tarafına başvurmak ya da tema üzerinden çözüm aramak gerekiyor.
Kendi yazılımınız varsa dosyayı statik olarak sunmak en basiti. Dinamik olarak üretiyorsanız içerik tipinin düz metin olmasına dikkat edin.
Güvenlik duvarı tarafında ne oluyor?
Burası en çok sürpriz yaşanan yer. Pek çok sitede yapay zekâ botları robots.txt’de açık ama güvenlik duvarı ya da CDN tarafından engelleniyor ve kimsenin haberi yok.
Cloudflare bir dönem yapay zekâ bot engelini varsayılan olarak açtı. Bunu üst üste birkaç sitede gördüm: site sahibi botların açık olduğunu düşünüyor, panelde bir anahtar kapatıyor.
Kontrol etmenin yolu basit. Sunucu loglarında o bot adlarını arayın. Hiç görünmüyorlarsa ya hiç gelmiyorlar ya da engellenmişler. Dönen durum kodlarına bakın; 403 görüyorsanız engelleniyorlar.
Bot koruması olan sistemlerde ayrı bir risk var: hızlı istek yapan botlar saldırı sanılıp otomatik engellenebiliyor. Bu durumda engeli kaldırmak için ilgili panelde kural yazmak gerekiyor.
Karar nasıl verilir?
Tek soruyla: içeriğiniz müşteri getirmek için mi var, yoksa içeriğin kendisi mi ürün?
Birinci durumdaysanız açık tutun. Bir mobilya mağazası, bir hizmet firması, bir e-ticaret sitesi için içerik satış aracı. Cevaplarda görünmek kazanç.
İkinci durumdaysanız kapatmayı değerlendirin. Abonelikle içerik satan bir yayın, özel araştırma yayımlayan bir kurum, kurs satan bir eğitimci. Orada içeriğin serbestçe kullanılması doğrudan gelir kaybı.
Arada kaldıysanız orta yolu kullanın: eğitim taramasını kapatın, cevap kurmayı açık tutun. Bu, pratikte çoğu işletme için en dengeli ayar.
Botların geldiğini nasıl görürsünüz?
Bu soruya cevap vermeden karar vermek, karanlıkta ayar yapmak gibi. Sunucu logları size gerçekte ne olduğunu söylüyor.
Barındırma panelinizde erişim kayıtlarına ulaşabiliyorsanız, bot adlarını arayın. Göreceğiniz üç şey var: botun gelip gelmediği, hangi sayfaları okuduğu ve dönen durum kodu.
Durum kodu önemli. 200 görüyorsanız bot sayfayı alabilmiş. 403 görüyorsanız engellenmiş ve bunu robots.txt değil muhtemelen güvenlik duvarı yapmış. 404 görüyorsanız istediği adres yok.
Loglara ulaşamıyorsanız bir alternatif var: Search Console’un Tarama İstatistikleri raporu Googlebot tarafını gösteriyor ama diğer botları göstermiyor. O yüzden sunucu loguna ulaşmaya çalışmaya değer; bu alanda elde edilebilecek en güvenilir veri orada.
Trafik olarak ne kadar geliyor?
Dürüst cevap: hacim olarak az. Sohbet araçlarından gelen yönlendirme trafiği, çoğu sitede toplam trafiğin küçük bir yüzdesi.
Ama niteliği farklı. O kişi bir cevap okudu, içinde sizi gördü ve tıklamayı seçti. Yani gelen kişi rastgele bir arama sonucuna tıklayan kişiden daha hazır geliyor.
Bunu ölçmek için analitikte ayrı bir bölüm kurun. Sohbet araçlarının alan adlarından gelen yönlendirmeleri bir grupta toplayın ve dönüşüm oranını genel ortalamayla karşılaştırın. Birkaç ay sonra elinizde gerçek bir rakam oluyor, tahmin değil.
Karar bir kez mi verilir?
Hayır ve bu alanda kararı sabit tutmak mantıklı değil. Botların listesi değişiyor, yeni isimler çıkıyor, platformların davranışı değişiyor.
Altı ayda bir gözden geçirmek yeterli. Bakılacak şeyler: robots.txt’de listelenmeyen yeni bot adları var mı, güvenlik duvarı tarafında bir şey değişti mi, sohbet araçlarından gelen trafik nasıl gidiyor.
Bir de şu: kararınızı yazılı tutun. Hangi botu neden açtığınız ya da kapattığınız bir yere not edilmeli. Aksi hâlde bir yıl sonra robots.txt’deki satırların neden orada olduğunu kimse hatırlamıyor.
Kısmi engelleme mümkün mü?
Mümkün ve bazı durumlarda en mantıklısı. Bütün siteyi kapatmak yerine belirli dizinleri kapatabiliyorsunuz.
Örneğin ücretli üyelere açık bir bölüm, indirilebilir dokümanlar ya da özel araştırma yayınlarınız varsa sadece o dizinleri kapatmak, geri kalan içeriği açık tutmak anlamlı oluyor. Kuralı dizin bazında yazmak yeterli.
Bu yaklaşımın avantajı şu: tanıtım içeriğiniz cevaplarda görünmeye devam ediyor, asıl değerli içeriğiniz korunuyor. Pratikte çoğu yayıncı için tam kapatmaktan daha dengeli bir ayar.
Dikkat edilecek bir şey var: kapattığınız dizinin adı robots.txt dosyasında yazılı oluyor ve o dosya herkese açık. Yani gizli tutmak istediğiniz bir dizin adını robots.txt’ye yazmak onu duyurmak anlamına geliyor. Gerçekten korunması gereken içerik için erişim kontrolü gerekiyor, robots.txt değil.
Botlar gerçekten geliyor mu?
Karar vermeden önce sunucu loguna bakın. Hangi botun geldiğini, hangi sayfaları okuduğunu ve hangi kodu aldığını orada görüyorsunuz.
grep -E 'GPTBot|ClaudeBot|PerplexityBot|OAI-SearchBot|Google-Extended' access.log | awk '{print $9}' | sort | uniq -c | sort -rnÇıktıda 200 görüyorsanız botlar sayfaları alabiliyor. 403 görüyorsanız engelleniyorlar ve bunu robots.txt değil büyük ihtimalle güvenlik duvarı ya da CDN yapıyor. Hiç satır dönmüyorsa ya hiç gelmemişler ya da kayıt tutulmuyor.
grep -E 'GPTBot|ClaudeBot|PerplexityBot' access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head -20İkinci komut hangi sayfaların okunduğunu veriyor. Bu liste, hangi içeriğinizin yapay zekâ tarafına gittiğini gösteren en doğrudan veri.
access.log dosyasını barındırma panelinizin kayıtlar bölümünden indirebilirsiniz; cPanel kullanan sunucularda ham erişim kayıtları bölümünde duruyor.
Özetle
Botları işlerine göre ayırın: eğitim için gelenler ile cevap kurmak için gelenler aynı şey değil. Çoğu işletme için en dengeli ayar, eğitim taramasını kapatıp cevap kurmayı açık tutmak. Googlebot ile Google-Extended’i karıştırmayın; birincisini kapatmak sizi arama sonuçlarından çıkarıyor. Ve kararı vermeden önce sunucu kaydına bakın, botların gerçekten gelip gelmediğini görün.