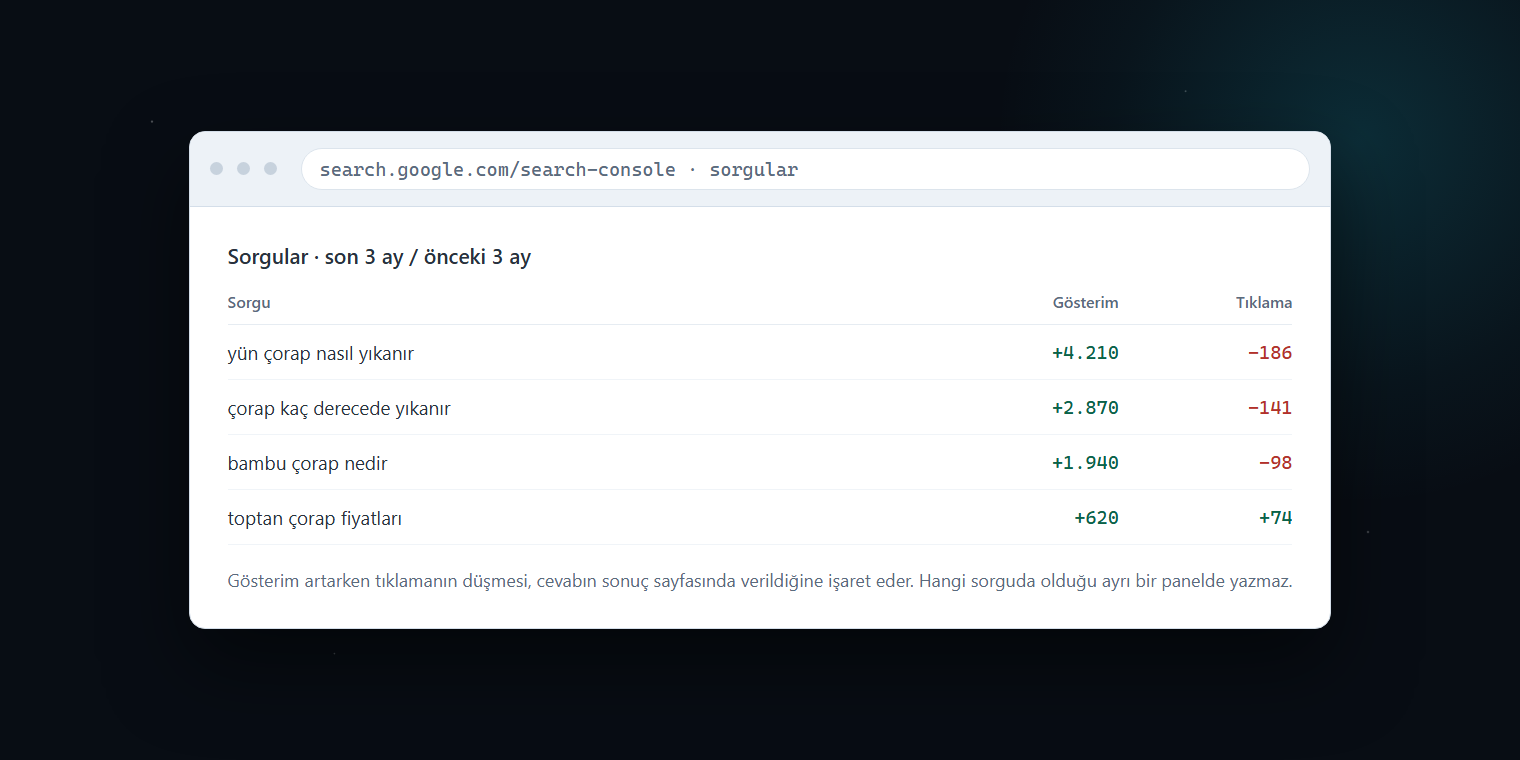
Raporlara “yapay zekâ trafiği” diye bir satır girdi gireli herkes bu rakamı büyütmenin peşinde. Kimse şu soruyu sormuyor: bu rakam neyi ölçüyor? Açık cevap: neredeyse hiçbir şeyi. Bu tarafı bugün kimse doğru düzgün ölçemiyor; ben de ölçemiyorum. Fark şu: ben neden ölçemediğimi ve elimdekiyle neyi ölçebileceğimi biliyorum. İşin hem yazılım tarafında (bir isteğin sunucuya nasıl düştüğü, kaydın nerede oluştuğu) hem SEO tarafında (çıkan rakamın ne anlama geldiği) çalıştığım için bu yazıyı üç soru üstüne kurdum: neyi ölçemiyoruz, neden ölçemiyoruz, nasıl ölçeriz.
Neyi ölçemiyoruz?
Aramada huni belliydi: gösterim, tıklama, oturum, dönüşüm. Search Console ilk ikisini verir, analitik gerisini. Aynı huniyi yapay zekâ tarafında kurmaya çalışın:
- Gösterim: kullanıcının sorusuna verilen cevapta markanızın ya da sayfanızın geçmesi. Bunu ölçmenin (Google’ın birazdan değineceğim yeni pilot raporu dışında) bugün bir yolu yok; olay platformun sunucusunda yaşanıyor ve dışarıya tek bir sinyal sızmıyor.
- Atıf: cevabın içinde veya altında kaynak olarak gösterilmeniz. Kullanıcı bunu görüyor, platform kendi tarafında logluyor; ama size raporlayan kimse olmadığı için bu da ölçülemiyor.
- Tıklama: kaynağa tıklanıp sitenize gelinmesi. Kısmen ölçülüyor; birazdan anlatacağım sebeplerle bir bölümü “direct” çukuruna düşüyor.
- Etki: o görünürlüğün satışa, başvuruya, marka aramasına dönmesi. Dolaylı izler dışında ölçüm yok.
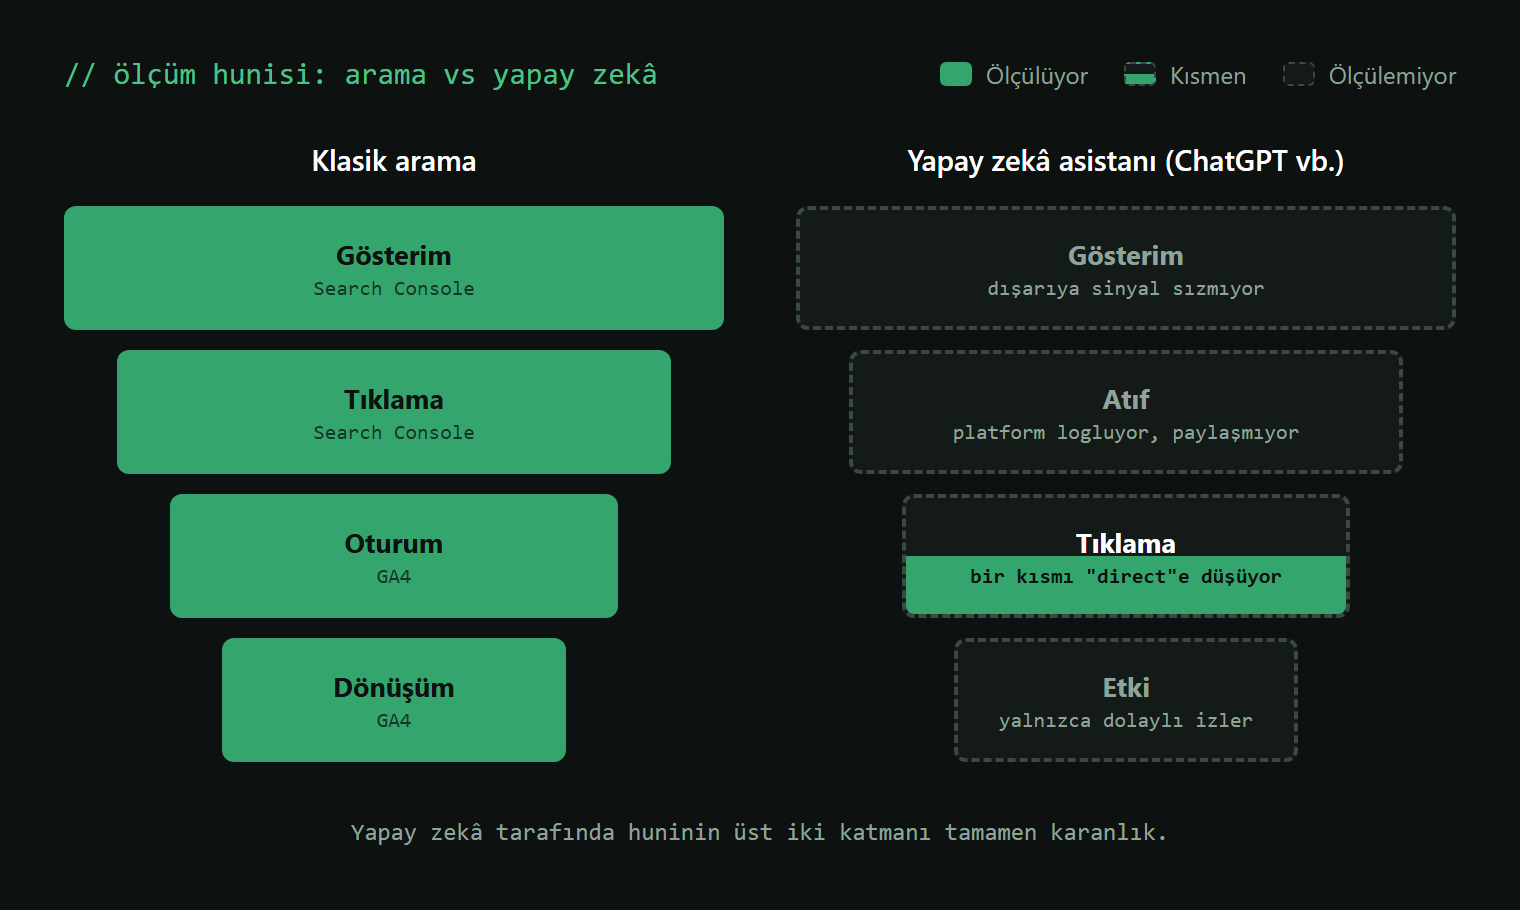
Yani huninin en üstteki iki katmanı tamamen karanlık, üçüncüsü yarı karanlık. Biz ise elimizdeki tek aydınlık parçayı, yani gelen üç beş tıklamayı alıp rapora “yapay zekâ performansımız” diye yazıyoruz. Ölçtüğümüz şey görünürlük değil; görünürlüğün kırıntısı.
Neden ölçemiyoruz?
Cevap tarafında telemetri yok
Kullanıcı ChatGPT’ye “X için en iyi Y hangisi” diye soruyor; model, eğitim verisinden ve gerekiyorsa o an yaptığı aramadan bir cevap kuruyor. Markanız o cevapta geçtiyse bir gösterim yaşandı; ama bu gösterim sizin hiçbir sisteminize dokunmadı. JavaScript’iniz çalışmadı, sunucunuza istek düşmedi, piksel atılmadı. Web analitiği baştan beri tek bir varsayım üzerine kurulu: kullanıcı bana gelir, ben de sayarım. Bu varsayım burada çöküyor; çünkü kullanıcı size gelmiyor, içeriğiniz ona gidiyor.
Yönlendiren (referrer) zinciri kırık
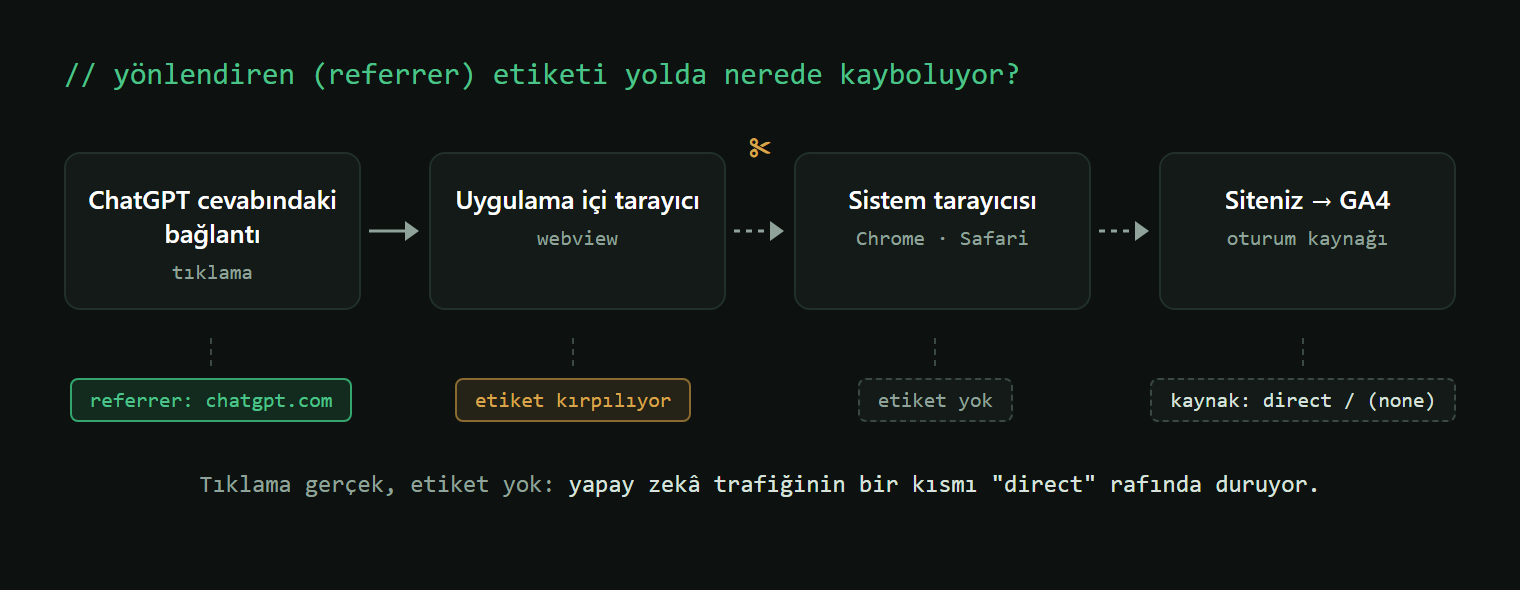
Tıklama olduğunda bile etiket sağlam gelmiyor ve zincirin nerede koptuğu teknik tarafta adım adım izlenebiliyor. Tarayıcıların varsayılan Referrer-Policy değeri (strict-origin-when-cross-origin) zaten yalnızca alan adını geçirir. Uygulama içi tarayıcılar (webview) çoğu zaman onu da geçirmez. Uygulamadan sistem tarayıcısına fırlatılan linklerde bağlam tamamen kopar. Üçünün de analitikteki karşılığı aynı: direct / none. OpenAI’ın dışarı verdiği linklere utm_source=chatgpt.com eklediği durumlar var; doğru yönde bir adım ama tutarlı değil ve diğer platformlarda karşılığı yok.
Bunu kendi verinizde test etmesi kolay: açılış sayfası kırılımında, derin sayfalarınıza gelen “direct” trafiğe bakın. Ana sayfaya direct girilir; kimse elle bir blog yazısının URL’sini yazmaz. O anomali büyük ihtimalle etiketi düşmüş trafiktir ve bir kısmı yapay zekâdan geliyordur. Hangi kısmı? İşte onu bilemezsiniz. Mesele tam olarak bu: kaybı tespit edebiliyorum, kaynağına bağlayamıyorum.
Site sahibine açılan gerçek bir panel hâlâ yok
Google bu cephede ilk somut adımı yeni attı: Haziran 2026’da Search Console’a, AI Overviews ve AI Mode gösterimlerini ayrı raporlayan bir üretken yapay zekâ performans raporu ekledi. Ama tabloya yakından bakınca eksik hemen görünüyor: rapor şimdilik pilot aşamasında (İngiltere’deki sitelerle başladı; sebep de iyi niyet değil, İngiliz rekabet kurumunun baskısı), yalnızca gösterim veriyor: tıklama yok, sorgu yok, geçmişe dönük veri yok. Doğru yönde bir ilk adım; panel değil. OpenAI’da ve Anthropic’te sıradan bir site sahibinin başvurup erişebileceği hiçbir ölçüm yüzeyi yok. Perplexity, medya ortaklığı programındaki büyük kuruluşlara (Time, Fortune gibi) makale bazlı atıf ve gelir panosu sunuyor; ama o kapı yalnızca programa alınmış bir avuç medya kuruluşuna açık. Sıradan site sahibi üçünde de dışarıda. İşin can sıkıcı tarafı verinin olmaması değil; hangi sorgularda hangi kaynakların gösterildiği, kaçının tıklandığı platform tarafında zaten loglanıyor. Eksik olan teknoloji değil, paylaşma iradesi.
Cevap deterministik değil
Klasik sıra takibi şu varsayıma dayanır: aynı sorguya herkes aşağı yukarı aynı sonucu görür. LLM tarafında bu varsayımın her parçası kırık. Model cevabı örnekleme (sampling) ile üretir; aynı soruyu aynı modele arka arkaya iki kez sorsanız bile farklı cevap alabilirsiniz. Model sürümü haber verilmeden değişir. Üstelik cevap çoğu üründe tek başına modelden çıkmıyor; modelin, arama indeksinin ve yeniden sıralama katmanının toplamından (RAG) çıkıyor ve bu üç katman birbirinden bağımsız değişiyor. Üstüne oturum hafızası ve kişiselleştirme binince “markam kaçıncı sırada” sorusu anlamını yitirir. Bu şartlarda ölçülebilecek tek şey dağılım: aynı soruyu N kez sorup markanızın kaçında anıldığına, yani anılma frekansına bakarsınız.
Araçlar ürünü değil, API’yi ölçüyor
Piyasadaki yapay zekâ görünürlük araçlarının yaptığı da tam olarak bu frekans ölçümü. Ama bu yaklaşımın üç ciddi kör noktası var. Birincisi, prompt setleri sentetik; gerçek kullanıcıların ne sorduğunu kimse bilmiyor, o veri de platformda. İkincisi, sorgular API’ye gidiyor; API cevabı, kişiselleştirmesi ve ürün katmanı olan uygulama cevabıyla aynı değil. Üçüncüsü, örneklem maliyet yüzünden küçük. Bu skorları trend okumak için kullanıyorum; mutlak değer olarak asla.
Taranmak, kullanılmak değil
Loglarda GPTBot görmek “görünürlüğüm var” demek değil. Üç ayrı olayı ayırmak gerekiyor: taranma (içeriğin toplanması), çağrılma (cevap üretilirken içeriğin o an çekilmesi) ve atıf (cevapta kaynak gösterilme). Aradaki dönüşüm oranlarını gösteren hiçbir veri elimizde yok. Bu arada sektörde yaygın bir yanlışı da düzelteyim: Google-Extended diye sitenizi gezen ayrı bir bot yok; o, Googlebot’un zaten topladığı verinin Gemini eğitiminde kullanılmasını kapatan bir robots.txt anahtarı. Loglarınızda Google-Extended diye bir bot ararsanız boşuna ararsınız.
Bugün elimizdekiyle nasıl ölçeriz?
1. Sunucu loglarını taksonomiyle okuyun
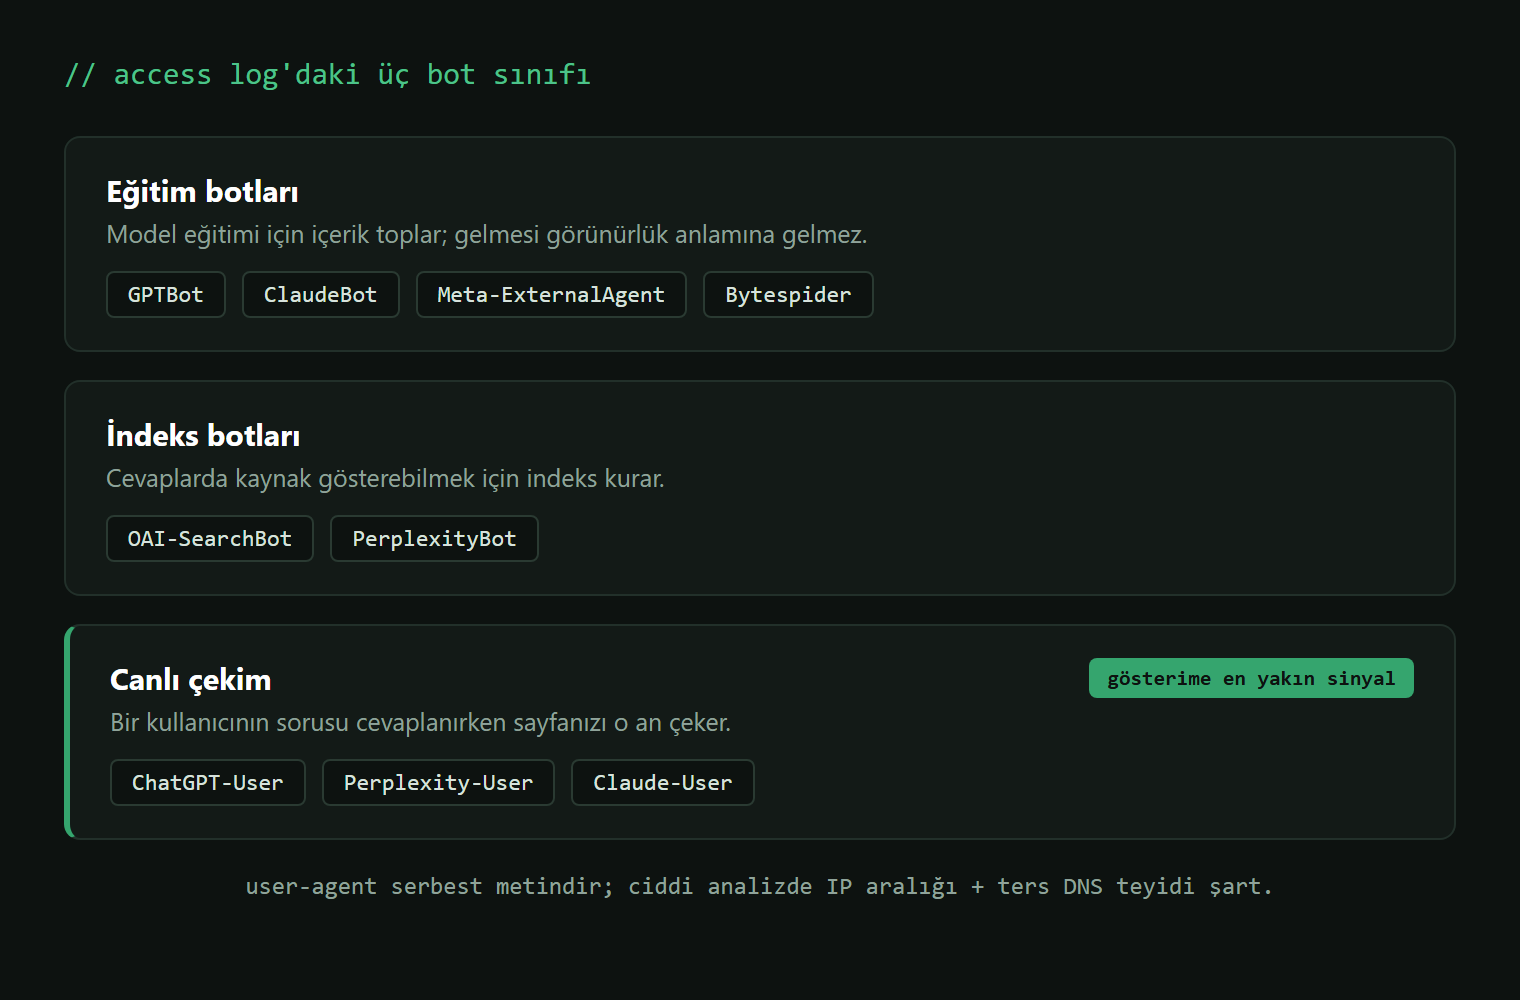
En dürüst veri hâlâ access log. Ama önce bot ayrımını doğru yapmak şart; üç sınıf var:
- Eğitim botları: GPTBot (OpenAI), ClaudeBot (Anthropic), Meta-ExternalAgent, Bytespider (ByteDance). Model eğitimi için veri toplar.
- İndeks botları: OAI-SearchBot (ChatGPT search), PerplexityBot. Cevaplarda kaynak gösterebilmek için indeks kurar.
- Canlı çekim: ChatGPT-User, Perplexity-User, Claude-User. Bir kullanıcının sorusu cevaplanırken sayfanız o an çekiliyorsa bu user-agent ile gelir.
Ayrımı yaptıktan sonra ilk bakış için iki satır yeter:
# hangi bot, kaç istek?
grep -oE "GPTBot|ClaudeBot|PerplexityBot|OAI-SearchBot|ChatGPT-User|Perplexity-User|Claude-User" access.log | sort | uniq -c | sort -rn

# canlı çekimler hangi sayfaları okuyor?
grep "ChatGPT-User" access.log | awk '{print $7}' | sort | uniq -c | sort -rn | head -20
Bu iki komutu, sunucuya SSH ile bağlanıp erişim kaydının bulunduğu dizinde çalıştırıyorsunuz; Nginx’te bu genelde /var/log/nginx/access.log olur, cPanel’li paylaşımlı hostinglerde ise panelin “Ham Erişim” (Raw Access) bölümünden indirdiğiniz dosya. İlk komut hangi botun kaç istek attığını, ikincisi canlı çekimlerin hangi sayfaları okuduğunu döker.
Bir de doğrulama şart: user-agent alanı serbest metindir, isteyen kendini GPTBot diye tanıtır. Ciddi bir analizde IP teyidi yapın; OpenAI ve Perplexity botlarının çıkış IP aralıklarını JSON olarak yayınlıyor, Googlebot gibi ters DNS kaydı tutan botlarda ise dig -x IP ile hızlı teyit mümkün. Baktığım loglarda kendini bilinen bot diye tanıtıp alakasız ağlardan gelen trafiği az görmedim.
2. Canlı çekimi gösterim vekili olarak kullanın
Üç sınıfın içinde asıl kıymetlisi canlı çekim. Bir ChatGPT-User isteği şu demek: şu anda bir kullanıcının sorusu cevaplanırken sayfanız okundu. Gösterim dediğimiz şeye bugün ulaşabileceğiniz en yakın sinyal bu. Bunu zaman serisine çevirin: gün gün kaç canlı çekim gelmiş, en çok hangi sayfalar çekilmiş. Hangi içeriğiniz cevap besliyor, hangisine hiç dokunulmuyor; bugün yapay zekâ görünürlüğü adına kurabileceğiniz en sağlam gösterge tablosu bu. Eksiğini de söyleyeyim: sayfanın çekilmesi cevapta kullanıldığını garanti etmez ve indeksten ya da önbellekten cevaplanan sorularda istek hiç gelmez. Yani vekil bir metrik; ama en azından neyi ölçtüğünü bildiğim, dürüst bir vekil.
3. Log erişiminiz yoksa kaydı kendiniz üretin
Hazır e-ticaret altyapılarının çoğu log vermez; bu ülkede işin büyük kısmı da böyle sitelerde dönüyor. Çözüm, kaydı altyapının önünde üretmek: siteyi bir CDN’in arkasına alıp uç sunucuda (edge) kendi telemetrinizi yazmak. Cloudflare Worker ile iskeleti şu kadar:
const AI_BOTLARI = /GPTBot|ClaudeBot|PerplexityBot|OAI-SearchBot|ChatGPT-User|Perplexity-User|Claude-User/;

export default {
  async fetch(istek, env, ctx) {
    const ua = istek.headers.get("user-agent") || "";
    const eslesme = ua.match(AI_BOTLARI);
    if (eslesme) {
      ctx.waitUntil(env.AI_KAYIT.writeDataPoint({
        blobs: [eslesme[0], new URL(istek.url).pathname],
        indexes: [eslesme[0]],
      }));
    }
    return fetch(istek);
  },
};
Bu Worker’ı Cloudflare panelinde Workers & Pages altında oluşturup alan adınıza rota (route) olarak bağlıyorsunuz; koddaki AI_KAYIT da aynı panelde tanımladığınız bir Analytics Engine bağlaması. Düşen kayıtları SQL ile sorguluyorsunuz; maliyeti yok denecek kadar az. Cloudflare’in hazır yapay zekâ botu raporları da var; ama kendi kaydını tutmak, soruyu kendin sorabilmek demek.
4. Analitiği arayüzden değil, ham veriden okuyun
GA4 tarafında ilk iş belli: oturum kaynağı chatgpt.com, perplexity.ai, gemini.google.com, copilot.microsoft.com ya da claude.ai olan oturumları ayrı bir segmentte toplamak. Ben bununla yetinmiyorum; çünkü arayüz veriyi kendi atribüsyon modelinden geçirip özetliyor. Aynı soruyu bir de BigQuery aktarımı üzerinden, ham olaya inerek soruyorum. Sayfa görüntüleme olayındaki page_referrer parametresi, kaynağın işlenmemiş hâlini taşıyor:
SELECT
  REGEXP_EXTRACT(
    (SELECT value.string_value FROM UNNEST(event_params) WHERE key = "page_referrer"),
    r"https?://([^/]+)") AS kaynak,
  COUNT(*) AS goruntuleme
FROM `proje.analytics_123456789.events_*`
WHERE event_name = "page_view"
  AND _TABLE_SUFFIX BETWEEN "20260701" AND "20260731"
  AND REGEXP_CONTAINS(
    (SELECT value.string_value FROM UNNEST(event_params) WHERE key = "page_referrer"),
    r"chatgpt.com|perplexity.ai|gemini.google.com|copilot.microsoft.com|claude.ai")
GROUP BY kaynak
ORDER BY goruntuleme DESC;
Bu sorgu için GA4 mülkünü BigQuery’ye bağlamanız yeterli (GA4’te Yönetici > BigQuery bağlantıları; aktarım ücretsiz, BigQuery’nin aylık ücretsiz kotası küçük ve orta boy bir siteye rahat yeter). Sorgudaki proje ve analytics_123456789 kısımlarını kendi proje ve veri kümesi adınızla değiştirip BigQuery konsoluna yapıştırıyorsunuz.
Arayüzle ham veri arasında fark çıkarsa (çıkar), doğru olan ham veridir.
5. Dolaylı izleri toplayın
Ölçemediğiniz şeyin gölgesini ölçersiniz. Ben üç gölgeye bakıyorum:
- Marka araması: yapay zekâ cevabında markanızı gören kullanıcının bir kısmı dönüp Google’a markanızı yazar. Yani yapay zekâ görünürlüğünün bir bölümü, ironik biçimde, Search Console’daki marka sorgusu trendinde saklıdır.
- Derin sayfa direct’i: yukarıda anlattım. Tek başına kanıt sayılmaz; ama izlemeye değer bir anomali.
- Beyan: form ve sipariş ekranına “Bizi nereden duydunuz?” alanı, seçeneklerden biri “ChatGPT / yapay zekâ”. Kulağa ilkel geliyor; ama sıfır tıklamalı gösterimi bugün yakalayabilen tek yöntem bu.
Asıl çözüm nerede?
Yukarıda saydıklarımın hepsi dolaylı yöntem; işi bir yere kadar idare eder, çözmez. Gerçek ölçüm için gerekenler belli ve hepsi platformların elinde:
- Search Console muadili bir panel: hangi sorgu kümelerinde kaç kez kaynak gösterildik, kaç tıklama aldık. Bu verinin tamamı şu anda platform loglarında duruyor; istense yarın açılabilir. Google’ın gösterimle sınırlı pilot raporu bunun teknik olarak mümkün olduğunun kanıtı; şimdi sorgu ve tıklama verisiyle tamamlanması ve herkese açılması gerekiyor.
- Ortak metrik standardı: yapay zekâ cevabında gösterimin ve atfın sektörce kabul edilmiş tanımı; dijital reklamdaki IAB standartlarının muadili. Standart yoksa her araç kendi skorunu uydurur.
- Çağrılma kayıtlarının açılması: cevap üretilirken hangi kaynağın çekildiği zaten sistemlerde kayıtlı; bunun site sahibine raporlanması gerekiyor. Telif tartışmaları büyüdükçe bu kayıtların açılması bence kaçınılmaz.
- Tutarlı kaynak parametresi: bütün platformların dışarı verdiği her linke standart, bozulmayan etiket. utm_source=chatgpt.com doğru bir başlangıç; ama istisna olmaktan çıkıp kural hâline gelmeli.
Search Console da bir günde olmadı; yıllar içinde, sektörün baskısıyla bugünkü hâline geldi. Aynı baskıyı şimdi bu platformlara kurmak gerekiyor.
Özetle ne yapmalı?
Bugünün dürüst tablosu şu: gösterimi ölçemiyoruz, atfı ölçemiyoruz. Tıklamanın bir kısmını, taramanın tamamını, canlı çekimi ve gölgeleri ölçebiliyoruz. O zaman yapılacak iş de belli: logları okuyacağız, uç sunucuda kendi kaydımızı tutacağız, analitiğin ham verisine ineceğiz, marka araması trendini izleyeceğiz. Rapora “yapay zekâ görünürlüğümüz şu” diye tek bir kesin rakam yazmayacağız; çünkü o rakam yok. Bize kesin rakam verene de şu soruyu soracağız: “Bu veriyi hangi telemetriden aldın?” Verilebilecek dürüst cevap ya “kendi prompt örneklemimizden” ya da “panel verisinden” olur; ikisi de telemetri değil, tahmin. Gerçek kullanıcı telemetrisi bugün yalnızca platformların elinde ve bizimle paylaşılmıyor.
Ölçüm yöntemleri yan yana
Bugün elimizde olan yöntemleri tek yere toplamak gerekirse, hangisinin ne kadar güvenilir olduğu şöyle duruyor.
| Yöntem | Ne gösteriyor | Güvenilirlik | Emek |
|---|---|---|---|
| Elle soru takibi | Belirli sorularda anılma | Orta, cevaplar değişken | Yüksek |
| Sunucu logu analizi | Hangi botlar geldi, hangi sayfaları okudu | Yüksek | Orta |
| Yönlendiren trafik | Sohbet araçlarından gelen ziyaret | Yüksek ama kısmi | Düşük |
| Search Console karşılaştırması | Gösterim sabit, tıklama düşüyor mu | Yüksek, dolaylı | Düşük |
| Üçüncü taraf araçlar | Toplu anılma tahmini | Değişken, doğrulanamıyor | Düşük |
Tablodaki en değerli iki satır ortada duranlar. Sunucu logu ve yönlendiren trafik, tahmin değil gerçekleşmiş olayı gösteriyor. Elle takip bir eğilim veriyor ama tek başına kanıt sayılmıyor. Son satıra ise temkinli yaklaşmak gerekiyor; o rakamların nasıl üretildiği genelde açıklanmıyor.
Pratik bir takip düzeni
Yukarıdaki yöntemleri birleştiren, ayda bir saatlik bir düzen kurmak mümkün.
- On soruluk sabit bir liste yapın, müşterinizin gerçekten soracağı sorular
- Ayda bir, iki üç araçta aynı soruları sorun ve cevapta geçen markaları not edin
- Sunucu logundan yapay zekâ botlarının hangi sayfaları okuduğunu çıkarın
- Analytics’te sohbet araçlarından gelen yönlendirmeleri ayrı bir bölümde takip edin
- Search Console’da gösterim ile tıklama farkını aylık karşılaştırın
Üç ay sonra elinizde bir eğilim oluyor. Kesin bir rakam değil, ama kararı yönlendirmeye yeter. Bu alanda zaten kesin rakam yok; olduğunu söyleyen araçlara temkinli yaklaşmak doğru.
Yapay zekâ görünürlüğü nasıl artırılır?
Ölçümü konuştuktan sonra kaçınılmaz soru bu. Ölçmek tek başına bir şey değiştirmiyor; değiştirecek olan işler şunlar.
Kapıyı açın. Yapay zekâ botları sitenize girebiliyor mu? Güvenlik duvarı, CDN ya da robots.txt engelliyorsa geri kalan hiçbir çalışmanın anlamı yok. Bu kontrol on dakika sürüyor ve en sık atlanan adım.
İçeriği okunabilir yapın. Metin sunucudan gelen HTML’de duruyor olmalı. Tarayıcıda JavaScript ile oluşturulan içeriği botların çoğu görmüyor. Görsele gömülü tablo ve fiyat listeleri de aynı şekilde okunmuyor.
Ne yaptığınızı düz bir cümleyle söyleyin. Ana sayfanız ve hakkımızda sayfanız, kim olduğunuzu ve ne yaptığınızı pazarlama dili olmadan anlatmalı. Buna ne yapmadığınızı eklemek de işe yarıyor; yanlış soruya cevap olarak önerilmenizi azaltıyor.
Üçüncü taraf kaynaklarda geçin. Cevaplar genelde markanın kendi sitesinden değil, ondan bahseden başka kaynaklardan kuruluyor. Sektör derlemeleri, karşılaştırma yazıları, haber içerikleri. Buranın kestirmesi yok ve asıl belirleyici olan da bu.
İşaretlemeyi kurun. Organization işaretlemesiyle markanızın adını, alan adını ve iletişim bilgisini açıkça bildirmek, aynı adı taşıyan başka şirketlerle karışmanızı azaltıyor.
Sıra önemli. İlk ikisi günler içinde bitiyor ve etkisi ölçülebiliyor. Dördüncüsü aylar sürüyor. Dördüncüye başlayıp ilk ikisini atlamak, en çok gördüğüm hata.