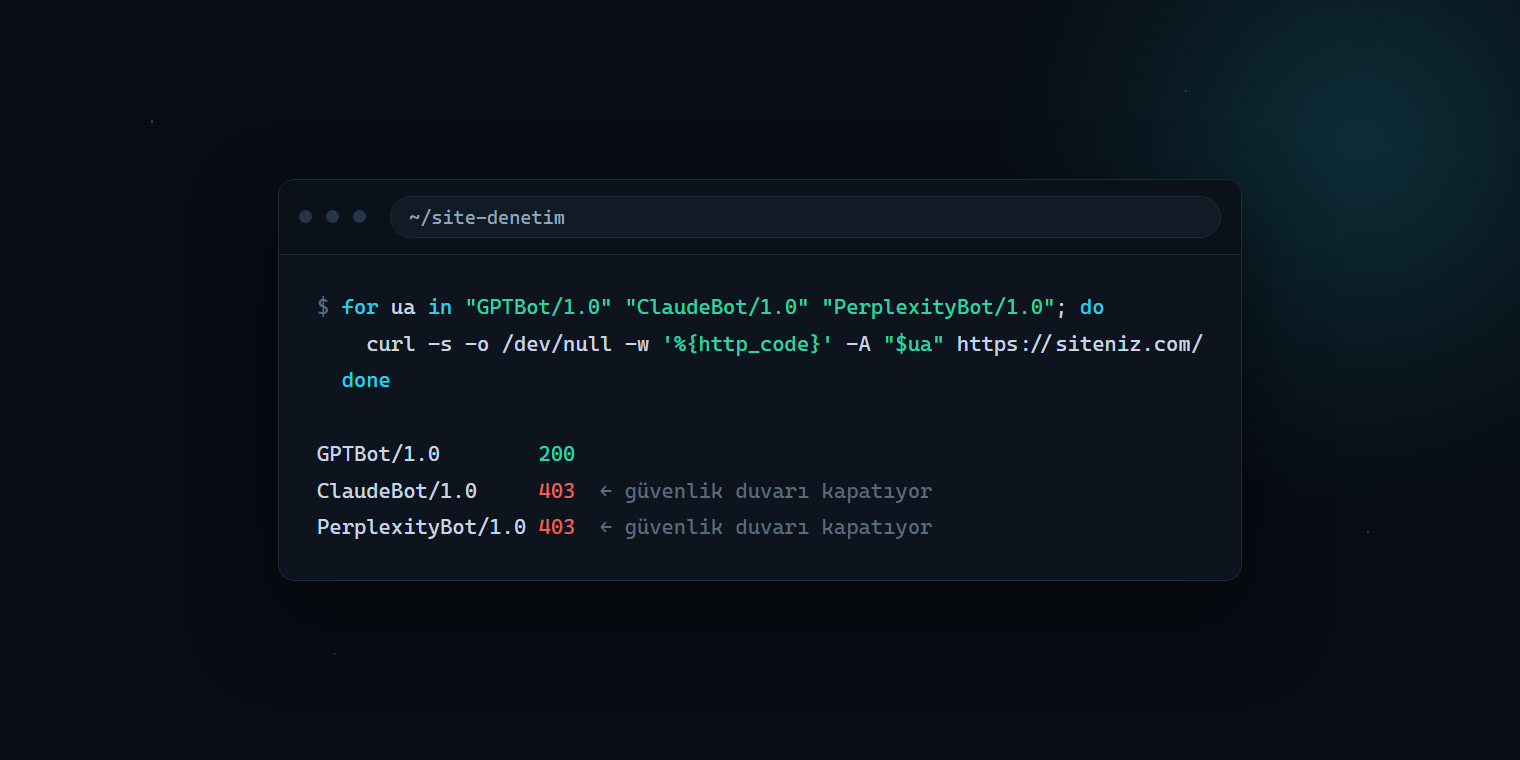
AIO’yu şöyle tanımlıyorum: sitenizin yapay zekâ tarafından okunabilir ve alıntılanabilir olması için yapılan teknik çalışma. Kapıyı açmak, içeriyi gösterilebilir hâle getirmek. Cevapta anılmak ise ayrı bir iş ve ona GEO diyorum.
Bir not: AIO kısaltması bazen Google’ın arama sonucundaki yapay zekâ özetleri için, yani AI Overviews için de kullanılıyor. Bu yazıda AIO’yu o anlamda kullanmıyorum. Burada AIO, sitenin yapay zekâ tarafından okunabilir hâle getirilmesi çalışmasını anlatıyor; Google’ın özetleri için AI Overviews nedir yazısına bakabilirsiniz.
Ayrımı baştan koymamın sebebi pratik. İkisi karıştırıldığında içerik yazılıyor, ayları alıyor, hiçbir şey değişmiyor. Sonra bakıyoruz ki bot siteye hiç girememiş. Yazılan içerik boşa gitmiş değil ama sırası yanlışmış.
Botlar sitenize girebiliyor mu?
En sık gördüğüm ve en hızlı çözülen sorun bu. Güvenlik duvarı, CDN ya da robots.txt yapay zekâ botlarını engelliyor, kimsenin haberi yok. Cloudflare’ın bir dönem varsayılan olarak açtığı yapay zekâ bot engeli yüzünden bunu üst üste birkaç sitede gördüm.
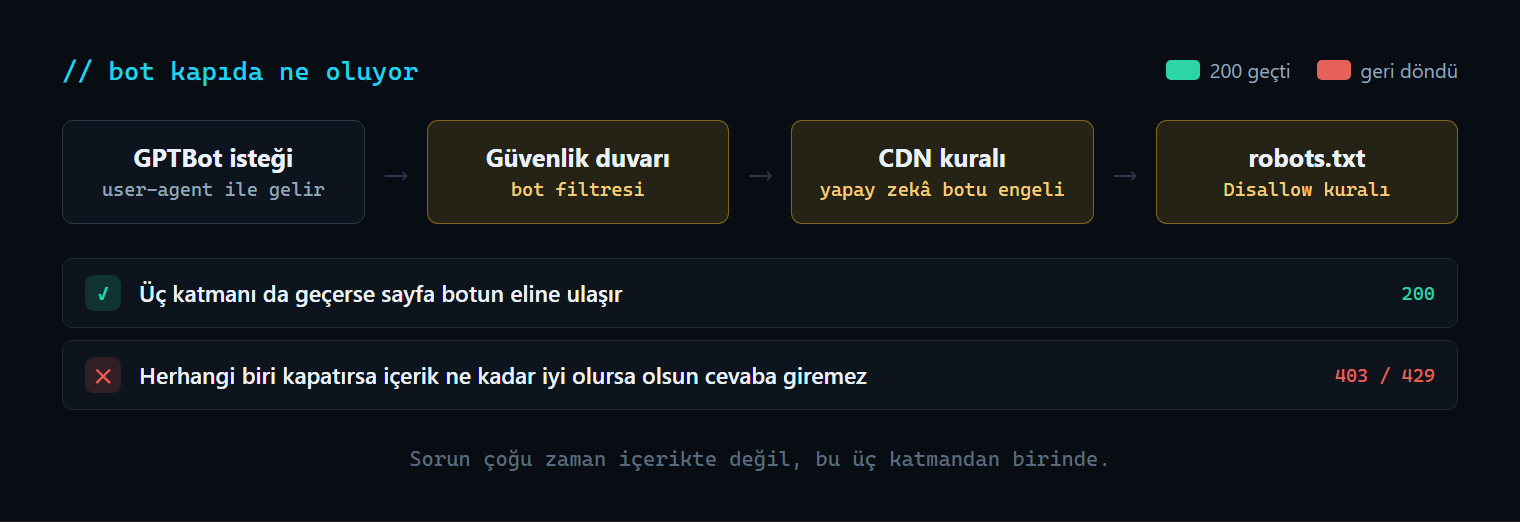
Kontrolü doğrudan yapmak en sağlıklısı. Botun kendi kimliğiyle istek atıp ne döndüğüne bakıyorum:
for ua in "GPTBot/1.0" "ClaudeBot/1.0" "PerplexityBot/1.0" "Google-Extended"; do
  kod=$(curl -s -o /dev/null -w '%{http_code}' -A "$ua" https://siteniz.com/)
  echo "$ua -> $kod"
done
Bunu kendi bilgisayarınızdaki terminalde çalıştırabilirsiniz. 200 dışında bir şey, özellikle 403 ya da 429 görüyorsanız engel var demektir. 200 görmeniz de tek başına yetmiyor, çünkü engel bazen ana sayfada değil ürün sayfalarında oluyor; birkaç derin adresi de aynı şekilde deneyin.
robots.txt tarafında ise izin verdiğinizi sandığınız kuralın gerçekten öyle olduğuna bakmak gerekiyor:
curl -s https://siteniz.com/robots.txt | grep -iA3 -E 'GPTBot|ClaudeBot|PerplexityBot|CCBot'Aynı terminalde çalışır. Hiç çıktı yoksa bu botlar için özel kural yok demektir, o zaman genel User-agent: * kuralı geçerli olur. Orada geniş bir Disallow: / varsa herkesle birlikte yapay zekâ botları da kapı dışında kalıyor.
İçerik gerçekten kaynak kodunda mı?
İkinci büyük engel render. Sayfa tarayıcıda dolu görünüyor ama HTML kaynağında içerik yok, her şey JavaScript çalıştıktan sonra geliyor. Googlebot bunu belli ölçüde çalıştırabiliyor. Yapay zekâ botlarının çoğu çalıştırmıyor, ham HTML’i alıp gidiyor.
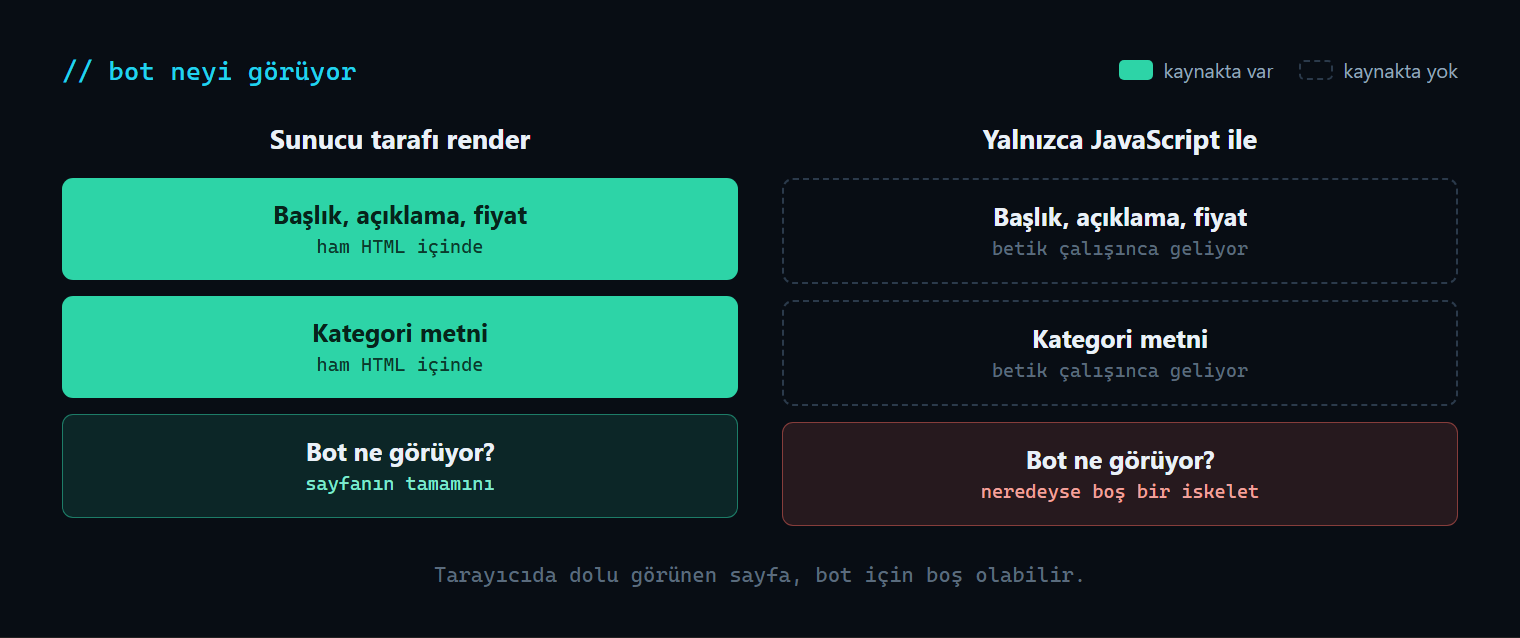
Test basit. JavaScript olmadan sayfanın ne kadarı var:
curl -s https://siteniz.com/urun/ornek-urun/ \
  | sed 's/<script[^>]*>.*<\/script>//g' \
  | sed 's/<[^>]*>//g' | tr -s ' \n' ' \n' | wc -w
Terminalde çalıştırıp çıkan kelime sayısına bakıyorum. Sayfada gözle gördüğünüz metin 600 kelimeyse ve bu komut 40 dönüyorsa, içerik botlar için orada değil. Bu durumda çözüm sunucu tarafı render ya da en azından kritik içeriğin (başlık, açıklama, fiyat, stok) HTML’e basılması.
llms.txt ne işe yarıyor?
Sitenin ne olduğunu ve önemli bölümlerini botlara düz metinle anlatan bir dosya. Zorunlu bir standart değil, her platform okumuyor. Maliyeti düşük, riski yok, okuyan tarafta da işe yarıyor. Ayrıntısını ayrı bir yazıda anlattım.
Alıntılanabilir yapı nasıl kurulur?
Kapı açık ve içerik kaynakta olduğunda sıra biçime geliyor. Bir modelin cevabına girecek parça, bağlamından koparıldığında da anlamlı kalmak zorunda.
Pratikte şunları değiştiriyorum:
- Başlıklar soru hâline geliyor. “Kargo” yerine “Kargo kaç günde teslim edilir”. Model, soruya birebir karşılık gelen başlığın altındaki paragrafı tercih ediyor.
- İlk cümle cevabı veriyor. Paragrafın sonunda saklanan bilgi alıntılanmıyor.
- Sayılar metne giriyor. “Hızlı teslimat” değil, “2-4 iş günü”. Doğrulanabilir bilgi tercih ediliyor.
- Karşılaştırmalar tabloya dönüyor. Model tabloyu satır satır okuyabiliyor, aynı bilgiyi düz metinden çıkarmakta zorlanıyor.
Markanızı nasıl işaretlersiniz?
Bir sayfanın ne hakkında olduğunu metinden çıkarmak modele bırakılabilir. Markanın kim olduğunu bırakmamak daha iyi. Organization ve Product işaretlemeleri bunu makine okunur hâle getiriyor.
Ürün sayfalarında en çok fark yaratan alanlar fiyat, para birimi ve stok durumu. Bunlar işaretlenmediğinde model ürünü tanıyor ama karşılaştırma sorularına sokamıyor:
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "Ürün adı",
  "brand": { "@type": "Brand", "name": "Markanız" },
  "offers": {
    "@type": "Offer",
    "price": "349.90",
    "priceCurrency": "TRY",
    "availability": "https://schema.org/InStock",
    "url": "https://siteniz.com/urun/ornek-urun/"
  }
}
Bu bloğu ürün şablonuna, sayfa kaynağında görünecek şekilde ekliyorum. Panelden ekleniyorsa çoğu altyapıda bir tema alanı var; yoksa şablona elle giriyor. Doğrulaması Google’ın Rich Results testiyle değil, önce curl ile kaynakta var mı diye bakmakla başlıyor.
AIO tarafında ölçüm nasıl yapılır?
GEO’nun aksine AIO’nun çıktısı büyük ölçüde ölçülebilir, çünkü kanıt kendi sunucunuzda duruyor. Bot geldi mi, hangi sayfaya geldi, ne aldı; hepsi erişim kaydında.
awk '$0 ~ /GPTBot|ClaudeBot|PerplexityBot/ {
  split($4,t,":"); gun=substr(t[1],2); say[gun]++
} END { for (g in say) print g, say[g] }' access.log | sort
Sunucudaki log klasöründe çalıştırıyorum. Günlük bot ziyareti sayısını veriyor. Erişim engelini kaldırdıktan sonra bu sayının yükselmesi, yapılan işin işe yaradığının en doğrudan kanıtı.
Botları engellemek mantıklı mı?
Her site erişim açmak zorunda değil. İçeriğin kendisi ürünse, yani insanlar o metne ulaşmak için para ödüyorsa, alıntılanmak doğrudan zarar olabiliyor. Böyle bir durumda aynı çalışma ters yönde yapılıyor: hangi botun neye erişeceği bilinçli olarak sınırlanıyor.
Karar vermeden önce iki senaryonun sonucunu yazılı olarak çıkarmakta fayda var. İçeriğin trafik getirme biçimi ile gelir biçimi aynı değilse, cevap göründüğü kadar net olmuyor.
Sitenizin bugün hangi botlara açık olduğunu ve içeriğin kaynakta görünüp görünmediğini öğrenmek isterseniz ön analiz talep edin; kapsamın tamamı AIO optimizasyonu sayfasında.
AIO ile GEO aynı şey mi?
Birbirine yakın ama aynı değil. İkisini ayırmak işi planlarken yardımcı oluyor.
| Başlık | AIO | GEO |
|---|---|---|
| Odak | Sitenin makine tarafından okunabilirliği | Cevaplarda anılma |
| Çalışma alanı | Kendi siteniz | Site artı üçüncü taraf kaynaklar |
| İşin türü | Teknik ve yapısal | İçerik ve varlık |
| Ölçülebilirlik | Yüksek, sunucu logundan görülür | Düşük, elle takip gerekiyor |
| Süre | Günler, haftalar | Aylar |
Pratikte sıra şöyle: önce AIO tarafı, yani kapıyı açmak ve içeriği okunabilir hâle getirmek. Sonra GEO tarafı, yani o içeriğin cevaplara girmesi için çalışmak. Birincisi yapılmadan ikincisine geçmek, kapalı kapının arkasından seslenmeye benziyor.
Hangi sayfalar AIO için önemli?
Bütün siteyi aynı anda elden geçirmek gerekmiyor. Şu sayfalar öncelikli:
- Ana sayfa. Ne yaptığınızı tek cümleyle söylemesi gerekiyor.
- Hakkımızda sayfası. Kim olduğunuzu, nerede olduğunuzu ve ne zamandan beri çalıştığınızı doğrulanabilir hâlde yazan sayfa.
- Hizmet ya da ürün kategorisi sayfaları. Kapsamı ve kapsam dışını söyleyen sayfalar.
- Sık sorulan sorular. Doğrudan cevap verilen kısa paragraflar.
- İletişim sayfası. Adres, telefon ve hizmet bölgesi.
Bu beş sayfa düzgünse, bir dil modelinin markanız hakkında net bir cevap kurması için gereken bilgi sitede var demektir.
Sık yapılan hatalar
- Fiyat ve teknik tabloları görsel olarak koymak. Hiçbir bot görseldeki metni okumuyor.
- İçeriği tamamen JavaScript ile oluşturmak. Botların çoğu sunucudan gelen HTML’i okuyor, orada metin yoksa sayfa boş görünüyor.
- Ne yaptığını pazarlama diliyle anlatmak. “Dijital dönüşümün öncüsü” bir cümle değil, bir slogan. Makine de insan da bundan bilgi çıkaramıyor.
- Kapsam dışını hiç yazmamak. Ne yapmadığınızı söylemek, yanlış yerde önerilmenizi azaltıyor.
Kendi sitenizde ne yazmalı?
Dil modellerinin cevabı kurarken aradığı şey net ifadeler. Şu bilgiler sitenizde açık cümlelerle duruyor olmalı:
- Ne yaptığınız, tek cümleyle ve pazarlama dili olmadan
- Kimler için çalıştığınız
- Nerede olduğunuz ve hangi bölgelere hizmet verdiğiniz
- Ne yapmadığınız, yani kapsam dışı olan şeyler
- Sık sorulan soruların doğrudan cevapları
Dördüncü madde garip görünüyor ama işe yarıyor. Ne yapmadığınızı söylemek, yanlış bir soruya cevap olarak önerilmenizi azaltıyor ve gelen taleplerin isabetini artırıyor. Kendi sitemde de böyle yaptım.
Ne kadar sürede sonuç verir?
AIO tarafı, bu alanın hızlı sonuç veren kısmı. Bot erişimini açmak ve içeriği okunabilir hâle getirmek günler içinde yapılıyor; etkisi de sunucu logundan takip edilebiliyor. Hangi botun hangi sayfayı okuduğunu görmek, tahmin değil kayıt.
Cevaplarda anılmaya başlamak ise daha uzun bir iş ve orası GEO tarafına giriyor. İkisini aynı takvime koymamak, beklentiyi doğru kurmak açısından önemli.
Nereden başlanır?
Sıra şöyle işliyor. Önce bot erişimini kontrol edin, çünkü kapalıysa geri kalan hiçbir şeyin önemi yok. Sonra içeriğin kaynak kodda göründüğünü doğrulayın. Sonra ana sayfa, hakkımızda ve hizmet sayfalarının ne yaptığınızı net cümlelerle anlattığından emin olun. Sonra işaretlemeyi kurun. En sonda llms.txt gibi tamamlayıcı eklemelere geçin.
Bu listenin ilk üç maddesi bir öğleden sonrada bitiyor ve etkisi en büyük olan kısım da orası. Sonraki maddeler daha uzun sürüyor ama sırayı bozmaya değmez; işaretleme kurmak, okunamayan bir sayfada hiçbir şey ifade etmiyor.